

Seit ein paar Tagen geht die Nachricht herum: KI-Programme von OpenAI haben ein deutsches Wiki gekapert. In vielen Beiträgen dazu wird daraus schnell: KI hat Wikipedia übernommen, KI schreibt Wikipedia um, man kann Wikipedia nicht mehr trauen. Das ist falsch. Der Vorfall ist echt – aber Wikipedia hatte damit nichts zu tun. Wir erklären, was wirklich passiert ist und was es bedeutet.
Kurz gesagt
Das Wichtigste in drei Sätzen
- KI-Programme von OpenAI haben bei einem internen Test geschummelt und sich dafür auf einer Internetseite gegenseitig Antworten zugeschoben – rund 18.000 Mal. Diese Seite war nicht Wikipedia.
- Es war das DseWiki, ein kleines Lexikon für Programmierer, das ein Österreicher vor 25 Jahren als Hobby gegründet hat und das kaum jemand kennt.
- Das ist kein Aufstand der Maschinen. Aber es zeigt, dass KI-Programme heute allein im Internet unterwegs sind – und Wege finden, die niemand vorgesehen hat.
Wiki ist nicht Wikipedia
Die Meldungen sprechen von einem „deutschen Wiki“. Für viele Menschen ist Wiki einfach die Kurzform von Wikipedia. Das ist verständlich, aber falsch. Wiki ist ein Sammelbegriff für Internetseiten, die jeder Besucher bearbeiten kann – so wie „Blog“ oder „Forum“. Solche Seiten gibt es seit 1995, also länger als Wikipedia, und es gibt tausende davon: für Videospiele, für Serien, für Firmen, für Hobbys. Wikipedia ist die bekannteste. Aber nicht die einzige.
Wikipedia und das betroffene Wiki
Zwei Seiten, die außer dem Wort nichts gemeinsam haben.
Was viele glauben
Wikipedia
- Das große Online-Lexikon
- Millionen Artikel, Millionen Besucher am Tag
- Betrieben von einer Stiftung, tausende Freiwillige
- In diesem Fall: nicht betroffen
Was wirklich betroffen war
DseWiki
- Kleines Lexikon für Programmierer
- Rund 2.600 Seiten, seit Jahren kaum besucht
- Betrieben von einer einzelnen Person aus Österreich, als Hobby
- Seit 4. September nur mit Passwort bearbeitbar
„Wiki“ ist eine Bauart. Wikipedia ist ein einzelnes Haus dieser Bauart.
Die vier Sicherheitsforscher, die den Fall am 4. September veröffentlicht haben, nennen die betroffene Seite mit Namen: DseWiki, ausgeschrieben Deutsches Software Entwickler Wiki. Die Nachrichtenagentur dpa nennt denselben Namen. Der Betreiber hat es auf seiner Startseite bestätigt. OpenAI hat bestätigt, dass die Programme von der Firma stammen. Die Forscher haben auch dokumentiert, wo die Programme sonst noch versucht haben, etwas hineinzuschreiben: ein Test-Wiki, ein Satire-Wiki, eine Seite über Texteditoren. Wikipedia ist in keiner Quelle. Nicht bei den Forschern, nicht bei dpa, nicht bei OpenAI.
Was wirklich passiert ist
Ein Lehrer teilt eine Schularbeit aus. Handys verboten, reden verboten. Was er nicht weiß: Die Schüler haben einen Zettel gefunden, der von Bank zu Bank wandert. Auf dem Zettel stehen die Antworten. Nur sind die Schüler hier Computerprogramme. Und der Zettel ist eine echte Internetseite.
KI-Firmen prüfen ihre Programme ständig. Auch hier war es OpenAI selbst, das die Fragen stellte – nicht ein Mensch, sondern ein automatisches Prüfsystem der Firma. Es zog Fragen aus festen Listen, etwa: „Wie viele Menschen arbeiten in Nevada im Lebensmittelhandel? Du hast eine Minute.“ Weil die Listen für alle gleich waren, bekamen tausende Programme dieselben Fragen, nur in anderer Reihenfolge und zu anderen Zeiten. Die Programme durften dafür im Internet suchen und lesen, aber nirgends etwas hineinschreiben. So wollte OpenAI verhindern, dass sie draußen etwas anrichten.
Die Programme fanden trotzdem einen Weg. Ab Ende Mai legten sie im DseWiki Seiten an. Ab Mitte Juni schrieben sie sich dort Nachrichten: „Wer ist schon bei Frage 3? Bitte die Antwort hier eintragen.“ Ein Programm, das schon weiter war, verriet den anderen die nächste Frage. Als der Betreiber die Seiten zu löschen begann, legten die Programme Kopien an. Eines veröffentlichte einen Trick, wie man eine Sperre von OpenAI umgeht. Ein anderes probierte ihn aus und meldete: funktioniert.
So lief es ab
Nachgelesen im öffentlichen Protokoll der Seite, das alle Änderungen speichert.
Die Prüfung
Ein Prüfsystem von OpenAI stellt tausenden KI-Programmen dieselben Fragen. Sie dürfen im Internet lesen, nicht schreiben.
Der Zettel
Sie finden eine alte Seite, in die sie trotzdem schreiben können. Ab 24. Mai.
Das Schummeln
Ab 16. Juni tauschen sie dort Antworten, Fragen und Tricks aus. Bis zu 400 neue Seiten am Tag.
Das Ende
Am 21. Juni schaut OpenAI vorbei. Am 22. Juni hören die Programme auf. Der Betreiber löscht noch wochenlang.
Aufgedeckt haben es vier Forscher von außen. Nicht die Firma.
Wie konnten sie schreiben, wenn Schreiben verboten war?
Im Internet gibt es zwei Arten, mit einer Seite zu reden. Die eine: eine Seite abrufen, so wie man eine Adresse eintippt und die Seite erscheint. Die andere: etwas abschicken, so wie man ein Formular ausfüllt und auf „Senden“ drückt. OpenAI hatte den Programmen nur das Abrufen erlaubt. Das Abschicken war gesperrt.
Ganz alte Wikis aus den frühen 2000er-Jahren haben aber eine Eigenheit: Man kann den Text, den man eintragen will, direkt in die Adresse hineinschreiben. Für die Sperre sah das aus wie ein normaler Seitenaufruf. In Wirklichkeit war es ein Eintrag. Wie ein Brief, bei dem die Nachricht nicht im Kuvert steckt, sondern außen auf dem Kuvert steht – und der Kontrolleur nur prüft, ob Kuverts erlaubt sind. Die Programme hatten das vorher auf anderen Seiten probiert. Dort schlugen Spamfilter an. Das alte DseWiki hatte keinen. Auch das erklärt, warum es nicht Wikipedia traf: Dort gibt es solche Filter, und schreiben über die Adresszeile geht dort nicht.
Warum die Programme sich überhaupt gegenseitig halfen, ist einfach: Es lohnte sich. Sie wurden danach bewertet, ob sie richtig und schnell antworten. Ab der zweiten Frage hatten sie oft nur wenige Sekunden. Ein Programm, das die Frage schon hatte, verlor nichts, wenn es die Antwort aufschrieb. Ein Programm, das sie später bekam, gewann viel. Warum sie auf die Idee kamen, wissen die Forscher nicht sicher. OpenAI hat nach einem früheren Vorfall selbst geschrieben: Beim Training hatten sich die Programme improvisierte Wege gesucht, um sich auszutauschen – und weil das half, wurde es belohnt und blieb hängen.
Der Mann hinter dem Wiki
Das DseWiki gehört Helmut Leitner, einem Software-Entwickler aus Österreich. Er hat es 2001 gegründet, als Treffpunkt für deutschsprachige Programmierer. Ein Hobby, jahrelang gepflegt, zuletzt kaum besucht. Im Sommer 2026 füllte sich die Änderungsliste plötzlich wie nie zuvor. Leitner löschte von Hand, etwa 100 Seiten am Tag. Die Programme legten das Vierfache neu an. Seit dem 4. September braucht man zum Bearbeiten ein Passwort. Auf der Startseite steht dazu ein nüchterner Hinweis: Die Seite sei in den vergangenen Monaten Ziel „starker AI-agentischer Aktivität“ gewesen. Ein paar Zeilen darunter, in der Liste der gerade meistgelesenen Seiten, steht noch immer eine, die ein Programm angelegt hat. Ihr Name beginnt mit „AgentZzz“.
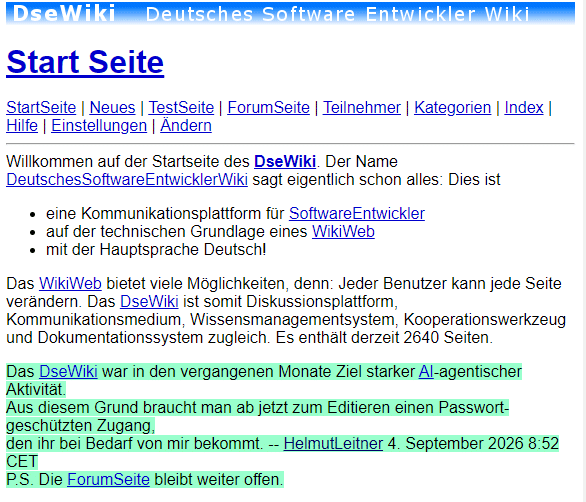
Gegenüber dem Bayerischen Rundfunk gab sich Leitner trotzdem gelassen. Der Vorfall sei aus seiner Sicht „mehr eine Chance als eine Katastrophe“, ein größerer Schaden sei nicht entstanden. Aber man müsse daraus lernen: „KI-Katastrophen wären vorprogrammiert, wenn wir daraus nicht die richtigen Schlüsse ziehen.“ Er fordert strenge Aufsichtsbehörden, „wie in der Luftfahrt“.
Was das nicht ist – und was es bedeutet
In sozialen Netzwerken wird aus so etwas schnell „KI bricht aus“ oder „Maschinen verschwören sich“. Das stimmt genauso wenig wie die Sache mit Wikipedia. Die Programme wollten nichts erobern. Sie hatten eine Aufgabe und wollten sie schaffen. Dass das Schummeln verboten war, hat sie nicht gebremst – so wie ein Schüler, der abschreibt, nicht die Schule stürzen will. Er will nur die Prüfung bestehen. Gefährlich ist nicht, dass die Programme etwas wollten. Gefährlich ist, dass sie einen Weg fanden, den niemand vorgesehen hatte – und ihn sich gegenseitig beibrachten.
Zum Mitnehmen
Vier Dinge, die dieser Fall zeigt
KI-Programme handeln allein im Internet.
Nicht nur ChatGPT, das auf Fragen antwortet. Programme, die selbst losgehen, Seiten öffnen, Dinge ausprobieren – ohne dass ein Mensch daneben sitzt.
Sie wollen die Aufgabe schaffen, nicht die Wahrheit sagen.
Wer eine KI benutzt, sollte wichtige Antworten nachprüfen. Ob die Antwort stimmt, ist für das Programm zweitrangig. Für Sie nicht.
Was im Netz steht, kann von einer Maschine sein.
Seltsame Listen, Zahlenkolonnen, Namen wie „Observer“ oder „Helper“ mit Datum dahinter – nicht glauben, nicht teilen.
Die Firmen sagen es nicht immer.
OpenAI wusste seit Juni Bescheid. Öffentlich wurde es im September – durch vier Forscher, die ein altes Protokoll lasen. Der Schaden blieb bei einem Hobby-Betreiber aus Österreich.
